第一次用Candreva是在一个数据清洗项目里,当时需要快速处理几十万条残缺记录吧?试过几个工具都不太顺手吧?
直到同事扔来一个Candreva的配置脚本是运行速度比预期快了近三倍,但且输出格式规整得不像话。从那以后。Candreva成了我工具箱里的常备选项。你也准备上手了,下面这几步能帮你少走弯路吧?安装Candreva最省事的方式是包管理器。以Python环境为例,直接pip install candreva即可的,要注意版本兼容性,0.9.x和1.x的API差异不小,老项目迁移时容易踩坑。我一般会新建虚拟环境,锁定版本号,避免依赖冲突。装完后跑一下candreva --version。
返回正常就说明环境没问题。Windows用户可能需要额外装Visual C++运行库,这点官方文档写得很隐蔽,第一次报错时我找了半小时才定位到。配置环节是Candreva发挥威力的很重要。
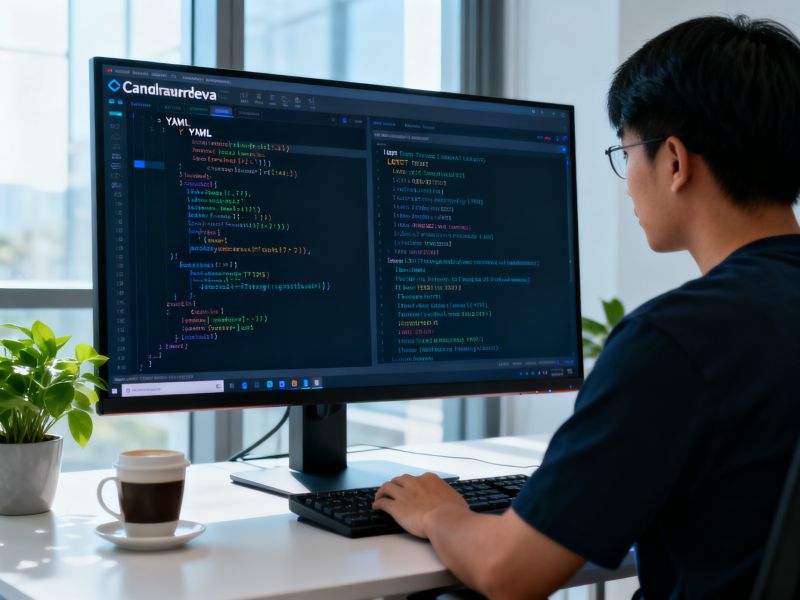
它的核心是一个YAML文件,定义数据源、处理管道和输出目标。清洗CSV时,可以这样写,pipeline: - type: filter condition: "age > 0"。不要被示例吓到,实际用起来比想象中简单的。我习惯把常用配置片段存成模板,下次直接复制修改。有个小技巧,Candreva支持环境变量插值了,把数据库密码之类的敏感信息放在.env文件里。配置里用${DB_PASS}引用,安全,但且方便了。调试阶段最容易卡在日志上了。Candreva默认只输出错误信息,想看详细执行过程得在配置里加log_level: debug。
有一次处理JSON嵌套结构的。转换结果总是丢字段,开了debug才发现是路径表达式写错了是少了个点号。细节问题靠猜根本找不出来。
Candreva的错误提示偶尔会指向不准确的行号,遇到莫名其妙的报错时,不妨把配置拆成几段分别测试吧?能更快锁定问题源头。性能调优方面了,Candreva的并行处理参数值得花时间研究。workers设成CPU核心数的1.5倍左右比较均衡。设太高反而因为上下文切换拖慢速度。处理大文件时,开启流式模式(stream: true)能好降低内存占用,我测试过一个2GB的日志文件,流式模式下内存峰值不到200MB。流式模式不支持某些聚合操作了,需要根据场景权衡了。
多跑几次基准测试吧?找到适合自己数据规模的配置组合,比盲目套用别人的参数靠谱得多。